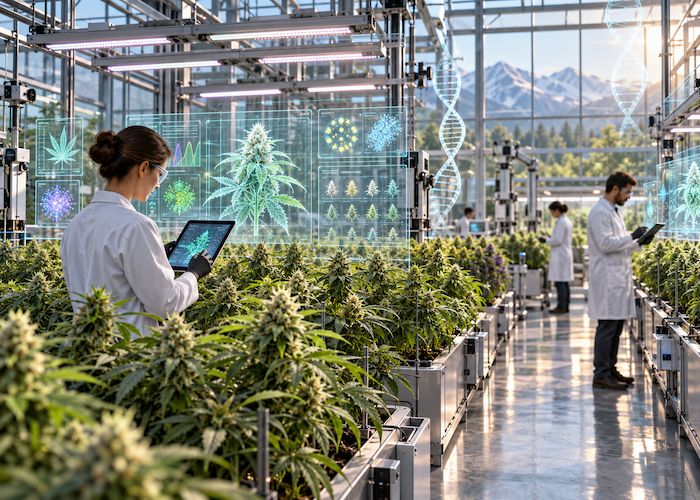
В канна-индустрии за последние годы сформировался значительный массив генетических, химических и фенотипических данных. Речь идет о результатах секвенирования сотен линий, протоколах хроматографического анализа каннабиноидов и терпенов, цифровых журналах выращивания с подробной фиксацией микроклимата и агротехнических параметров. Объем этой информации уже выходит за рамки ручного анализа и требует системных методов обработки.
Массовое секвенирование нового поколения, стандартизированные методы ВЭЖХ и ГХ-МС, а также программные платформы для учета фенотипов создали технологическую базу для перехода к более точной селекции. Появилась возможность сопоставлять генетические маркеры с химическим профилем и параметрами роста в единой цифровой среде. В центре этого этапа находится машинное обучение как инструмент статистического анализа сложных биологических систем, где учитываются десятки и сотни переменных одновременно.
Речь идет не о замене селекционера алгоритмом, а о расширении аналитического инструментария. Каннабис характеризуется высокой внутривидовой вариабельностью, а синтез каннабиноидов определяется работой нескольких ферментных путей и их регуляцией. Дополнительное влияние оказывают освещение, питание и микроклимат. В таких условиях математические модели становятся практическим инструментом для структурирования данных и оценки вероятных комбинаций признаков внутри широкого генетического разнообразия.
Цифровой портрет растения
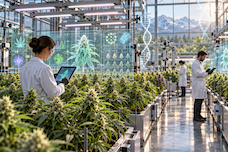
Современная селекция все чаще опирается на формирование комплексного цифрового профиля растения. Такой профиль представляет собой структурированный набор данных, который описывает растение на нескольких уровнях. В него входят результаты генотипирования, показатели экспрессии ключевых генов, данные лабораторного анализа каннабиноидов и терпенов, морфологические параметры, темпы роста, плотность и архитектура соцветий, сроки начала и продолжительности цветения, а также реакция на абиотические и биотические стрессы.
Дополнительно в цифровой портрет могут включаться параметры условий выращивания. Информация о спектре и интенсивности освещения, режиме полива, составе питательного раствора и микроклимате позволяет точнее интерпретировать проявление признаков. В результате формируется многомерное описание, где каждый образец представлен не одним показателем, а совокупностью взаимосвязанных характеристик.
Каждый из этих параметров по отдельности используется в селекции на протяжении десятилетий. Новизна современного подхода заключается в их одновременной обработке и сопоставлении. Алгоритмы машинного обучения анализируют сотни переменных и выявляют устойчивые статистические связи между маркерами ДНК, условиями среды и конечными фенотипическими признаками. Такой подход позволяет переходить от описательной селекции, основанной на наблюдениях, к прогностической, где решения принимаются на основе вероятностных моделей.
Генетические маркеры и химический профиль
Биосинтез каннабиноидов определяется активностью ферментных систем, кодируемых определенными генами. Вариации нуклеотидных последовательностей, различия в числе копий генов и особенности регуляции экспрессии отражаются на концентрации ТГК, КБД и сопутствующих соединений. Даже небольшие изменения в структуре этих генов могут приводить к заметным сдвигам в химическом профиле соцветий.
Машинное обучение применяется для оценки вклада каждого маркера в формирование итогового состава. Модели обучаются на выборках, где для каждого растения известны генетические данные, параметры выращивания и результаты хроматографического анализа. Используются методы линейной и нелинейной регрессии, ансамблевые алгоритмы и нейронные сети. Их задача состоит в прогнозировании вероятного химического профиля растения еще до начала цветения.
Практическая выгода такого подхода заключается в оптимизации селекционного процесса. Предварительный скрининг по цифровому профилю снижает количество растений, которые необходимо выращивать до полной зрелости и направлять на лабораторную проверку. Это сокращает затраты на пространство, энергию и реагенты, а также уменьшает длительность селекционного цикла без потери точности отбора.
Минорные каннабиноиды и анализ больших коллекций
Расширение аналитических возможностей заметно продвинуло исследование минорных каннабиноидов. Современные методы высокоэффективной жидкостной хроматографии и масс-спектрометрии позволяют выявлять соединения, присутствующие в очень низких концентрациях, иногда на уровне долей процента. Ранее такие компоненты могли оставаться вне отчетности из-за ограниченной чувствительности приборов или фокуса исследований на доминирующих каннабиноидах.
Минорные соединения часто формируются в результате тонких вариаций в ферментативных путях. Изменения в структуре генов синтаз, регуляторных участках ДНК или в числе копий генов способны смещать метаболический поток в сторону альтернативных продуктов. В ряде случаев вклад вносит и активность ферментов, участвующих в окислительных или изомеризационных процессах. Для выявления таких особенностей требуется анализ широких популяций, поскольку редкие комбинации встречаются с низкой частотой.
При работе с крупными генетическими банками задача заключается в систематизации огромного объема информации. Коллекции могут включать сотни и тысячи образцов, каждый из которых характеризуется десятками параметров. Машинное обучение позволяет проводить многомерную сортировку, выявляя образцы с нетипичными сочетаниями маркеров и метаболических показателей.
Алгоритмы учитывают полиморфизмы, вариации числа копий генов, данные о транскрипционной активности и количественные показатели химического анализа. Такой подход снижает вероятность пропуска перспективных линий и оптимизирует распределение ресурсов. После предварительного отбора образцы проходят лабораторную проверку с использованием повторных измерений для подтверждения стабильности профиля.
Интеграция геномики и метаболомики позволяет сопоставлять наличие гена с его реальной функциональной активностью. Это важно, поскольку экспрессия может варьировать в зависимости от генетического фона и условий выращивания. Модели учитывают эти различия и формируют более точные прогнозы по вероятности синтеза редких соединений.
Учет среды и фенотипическая пластичность
Каннабис характеризуется выраженной фенотипической пластичностью. Химический профиль, морфология и темпы роста могут существенно изменяться при колебаниях освещения, спектра, интенсивности фотопериода, режима питания и влажности воздуха. Даже при идентичном генотипе результаты анализа могут отличаться при изменении микроклимата.
Поэтому современные предиктивные модели включают переменные среды наряду с генетическими маркерами. В базы данных добавляются параметры температуры, относительной влажности, интенсивности и спектра света, состава субстрата и режима полива. Это позволяет статистически разделить вклад генетики и условий выращивания, повышая точность прогнозов.
Учет среды особенно важен при оценке устойчивости к стрессам. Генетическая предрасположенность к толерантности к засухе, перепадам температуры или повышенной влажности проявляется в конкретных условиях. Алгоритмы анализируют данные полевых и тепличных испытаний совместно, выявляя устойчивые закономерности между генотипом и реакцией растения. Такой комплексный анализ снижает риск неверной интерпретации и делает результаты селекции более воспроизводимыми.
Планирование гибридизации
AI используется не только для анализа уже существующих линий, но и на этапе проектирования новых комбинаций. В селекции каннабиса гибридизация остается ключевым инструментом формирования желаемых признаков, однако традиционно выбор родительских форм во многом опирался на фенотипическую оценку и опыт специалиста. С появлением генотипирования и предиктивных моделей процесс стал более структурированным.
На основе генетической дистанции между линиями, анализа полиморфизмов и данных о наследуемости конкретных признаков можно рассчитывать вероятность передачи тех или иных характеристик потомству. Модели учитывают распределение аллелей, возможные комбинации генов синтаз, а также известные ассоциации между маркерами и химическим профилем. В расчет могут включаться данные о сроках цветения, морфологии кроны, плотности соцветий и устойчивости к стрессовым факторам.
Селекционер получает инструмент для моделирования сценариев до фактического скрещивания. Алгоритм не выдает гарантированный результат, поскольку наследование признаков остается вероятностным процессом. Однако модель позволяет оценить диапазон возможных фенотипов и распределение вероятностей внутри популяции F1 или последующих поколений. Это упрощает планирование программ, позволяет оптимизировать количество тестируемых комбинаций и снижает долю случайных решений.
Дополнительно цифровые модели помогают оценивать риск накопления нежелательных признаков при работе с близкородственными линиями. Анализ генетической дистанции и уровней гомозиготности снижает вероятность инбридинговых эффектов и помогает поддерживать генетическое разнообразие внутри программы.
Инфраструктура данных
Эффективность цифровой селекции напрямую зависит от качества и структуры исходных данных. Для корректной работы моделей необходимы стандартизированные протоколы секвенирования, единые методики подготовки проб для химического анализа и повторяемость измерений. Без сопоставимости результатов между лабораториями статистические связи теряют надежность.
Важным условием является прозрачность методик. Описание условий выращивания, параметров освещения, состава питательных растворов и режима полива должно сопровождать генетические и химические данные. Это позволяет учитывать влияние среды и корректно интерпретировать различия между образцами.
Каннабис только формирует масштабные базы геномной информации, сопоставимые с базами по зерновым культурам или овощным видам. По мере расширения выборок и накопления стандартизированных данных точность предиктивных моделей будет возрастать. Создание открытых или отраслевых баз данных способно ускорить развитие предиктивных систем, повысить сопоставимость результатов между исследовательскими центрами и укрепить научную основу селекционных программ.
Границы технологии
Машинное обучение выявляет статистические закономерности между переменными, однако объяснение биологических механизмов остается задачей исследователя. Алгоритм фиксирует корреляции, но не раскрывает причинно-следственные связи без дополнительного анализа. Поэтому интерпретация результатов требует знания молекулярной генетики, биохимии каннабиноидного пути и особенностей регуляции экспрессии генов.
Модели чувствительны к объему и структуре выборки. При ограниченном количестве образцов возрастает риск переобучения, когда алгоритм хорошо описывает обучающие данные, но теряет точность при применении к новым популяциям. Дополнительные сложности возникают при дисбалансе классов, например, когда редкий химический профиль представлен единичными образцами.
Отдельным фактором является генетическая неоднородность популяций. Линии каннабиса формировались в разных регионах и исторических условиях селекции, что привело к различиям в структуре генома и частоте аллелей. Модель, обученная на одной коллекции, может демонстрировать снижение точности при переносе на другую. Это требует калибровки алгоритмов и проверки их воспроизводимости на независимых наборах данных.
Также следует учитывать влияние среды и вариативность лабораторных протоколов. Различия в методах экстракции, настройке оборудования и условиях выращивания могут вносить систематические смещения. Без стандартизации процессов интерпретация результатов становится менее надежной.
Вывод
ИИ в селекции каннабиса представляет собой инструмент системного анализа сложных биологических массивов. Генетические маркеры, данные экспрессии генов, параметры среды и результаты химического анализа объединяются в единую аналитическую модель. Это позволяет работать с большим числом признаков одновременно и оценивать их совокупное влияние на конечный фенотип.
При наличии стандартизированных данных и достаточного объема выборок машинное обучение повышает точность отбора, сокращает время поиска редких профилей и улучшает прогноз устойчивости к стрессам. Технология расширяет аналитические возможности селекционера, способствует более структурированному планированию гибридизации и формирует управляемый подход к созданию новых фенотипов при сохранении научной обоснованности решений.
Источники:
- Houston, A. (2025, December 10). Marijuana breeders can use AI to design new strains, study demonstrates. Marijuana Moment.
- Najafabadi, M. Y. (2025). Machine learning-enhanced multi-trait genomic prediction for optimizing cannabinoid profiles in Cannabis sativa. The Plant Journal.
- Çay, T. (2024). Prediction of THC levels in Cannabis species using machine learning methods. Bozok Journal of Agriculture and Natural Sciences, 3(2), 125–136.



Будьте первым!